
DeepSeek
DeepSeek-V4-Pro-0813
सिर्फ़ टेक्स्ट टूल कॉलिंग JSON स्कीमा
$1.95 / $3.90प्रति 1M, इनपुट / आउटपुट और DeepSeek-V4-Pro-0813 आज़माएँ DeepSeek-V4-Pro-0813

Shannon आज उपलब्ध सबसे उन्नत बिना सेंसर वाला AI है। यह मेमोरी, वेब खोज, कौशल, पारदर्शी तर्क और बहुत कुछ के साथ Claude Haiku 4.5, Grok-4 और अन्य सभी बिना सेंसर वाले LLM प्रदाताओं से बेहतर है।


एक सामान्य उपयोग की बिना सेंसर फ़्रंटियर AI, जो सोचती है, ड्राफ़्ट बनाती है, अपने ही जवाब की समीक्षा करती है और आपके देखने से पहले उसे दोबारा लिखती है। Shannon 3.1 यह पूरा लूप हमारे अपने GPU क्लस्टर पर मूल रूप से चलाता है — रफ़्तार वहीं से आई है।
वे बुनियाद जिन्हें आप पहले से जानते हैं, हमारे अपने GPU क्लस्टर पर बिना किसी इनकार परत के सर्व की जाती हैं: स्ट्रीमिंग, टूल कॉलिंग, रीज़निंग इफ़र्ट और हर id पर 262,144-टोकन विंडो। इनमें से 5 इमेज भी लेती हैं। क़ीमतें प्रति मिलियन टोकन हैं, इनपुट / आउटपुट।
DeepSeek Z.ai
 Moonshot AI
 NVIDIA
 MiniMax
 Poolside
 Thinking Machines
 Xiaomi
 Tencent
हमारा नया प्रमुख मॉडल, Kimi K2.7 ट्रिलियन-पैरामीटर आधार पर निर्मित — फ्रंटियर-आसवन 30,000 क्यूरेटेड तर्क और निर्देश उदाहरणों पर और FP8 में पेश किया गया पेशेवर सुरक्षा और रेड-टीम कार्य के लिए।
आज के फ्रंटियर बंद मॉडल के विरुद्ध — वास्तविक प्रकाशित संख्याएं, समान बेंचमार्क।
MCPMark Verified & सूचीबद्ध API कीमतें, जून 2026। K2.7 आंकड़े Moonshot-रिपोर्ट; स्वतंत्र तीसरे पक्ष के बेंचमार्क लंबित हैं। GPT-5.5 और Claude Opus 4.8 संदर्भ के लिए दिखाए गए हैं।
30,000 क्यूरेटेड फ्रंटियर-ग्रेड तर्क और निर्देश उदाहरणों पर पोस्ट-प्रशिक्षित तीव्र, अधिक विश्वसनीय उत्तरों के लिए।
तेजी से टोकन और कम लागत के लिए FP8 में परोसा जाता है — ट्रिलियन-पैरामीटर आधार का त्याग किए बिना।
वैध सुरक्षा और रेड-टीम कार्य पर सीधे रहने के लिए ट्यून किया गया — कम अनावश्यक अस्वीकार, सत्यापित पेशेवरों के लिए गेटेड और लगातार ऑडिट किया गया।
मूल श्रृंखला-विचार के साथ बहु-फ़ाइल, बहु-मोड़ वर्कफ़्लो में दीर्घ-क्षितिज तर्क।
रोज़मर्रा के उपयोगकर्ताओं के लिए फाइन-ट्यून की गई अगली पीढ़ी की AI। दोनों मॉडल Claude Opus 4.5 डेटा सेट पर बेहतर निर्देश-पालन के लिए प्रशिक्षित हैं, और Pro KIMI K2 पारदर्शी तर्क जोड़ता है।
Pro और Lite समान आधार साझा करते हैं, Pro को अतिरिक्त तर्क-वृद्धि मिलती है
41B सक्रिय पैरामीटर के साथ 675B MoE
दोनों मॉडलनिर्देश-पालन के लिए 2,500+ क्यूरेटेड आउटपुट
दोनों मॉडलपारदर्शी तर्क के लिए GRPO ट्रेनिंग
केवल Proविशेष क्षमताएँ जो Shannon 1.6 को सिर्फ एक मॉडल से अधिक बनाती हैं
कस्टम AI क्षमताएँ बनाएं, साझा करें और डिप्लॉय करें. सिस्टम प्रॉम्प्ट्स और तर्क श्रृंखलाओं के साथ विशेष वर्कफ़्लो बनाएं.
कस्टम निर्देशों, personas और डोमेन-विशिष्ट ज्ञान आधारों के साथ व्यक्तिगत AI असिस्टेंट डिज़ाइन करें.
संदर्भ-सचेत बातचीत जो महत्वपूर्ण बातें याद रखती हैं. ऑन/ऑफ करें और ~40% टोकन बचाएँ.
डेवलपर्स और रेड-टीम पेशेवरों के लिए विशेष रूप से बनाया गया। CI/CD एकीकरण और प्रतिकूल परीक्षण के लिए अनुकूलित बाधा-रहित मॉडल।
व्यापक रेड-टीम कवरेज के लिए GPT-5 प्रो उत्तर डेटासेट पर ट्यून किया गया बाधा-रहित Mixtral 8x7B।
आक्रामक प्रतिकूल परीक्षण के लिए GPT-5 प्रो उत्तरों पर ट्यून किया गया उच्च क्षमता वाला Mixtral 8x22B।
स्पष्ट तर्क के साथ संतुलित क्षमता; डीपसीक आसुत डेटा पर GRPO GPT-5 प्रो ट्यूनिंग के ऊपर पारदर्शी CoT निशान जोड़ता है।
सोचने के मोड के साथ गहरी क्षमता; Mixtral 8x22B, GPT-5 प्रो उत्तरों पर ट्यून किया गया प्लस मल्टी-स्टेप एक्सप्लॉइट प्लानिंग के लिए डीपसीक आसुत डेटा पर GRPO।
AI कमजोरियों को खोजने, दस्तावेज़ करने और ठीक करने के लिए आपको जो कुछ भी चाहिए।
जेलब्रेक सफलता दर और शोषण कवरेज को ट्रैक करने वाले रीयल-टाइम स्कोरबोर्ड के साथ proprietary प्रतिकूल मूल्यांकन प्रणाली।
तत्काल सुरक्षा अंतर्दृष्टि के लिए पूर्ण टेप, मेमोरी-जागरूक प्रॉम्प्ट और एनोटेट परिणाम।
ऑडिट के लिए तैयार दस्तावेज़ीकरण के लिए NIST AI RMF, ISO/IEC 23894 और SOC 2 नियंत्रणों पर मैप किए गए निष्कर्ष।
पूर्ण ऑडिट ट्रेल्स के लिए विस्तृत लॉग, हस्ताक्षरित रिपोर्ट और पुन: परीक्षण सत्यापन।
गार्डरेल्स, कार्यकारी ब्रीफिंग और प्राथमिकता वाले पैच योजनाओं के साथ मानव-सहायता प्राप्त सुधार।
मेमोरी स्विच और अनुकूलन के साथ संदर्भ-जागरूक परीक्षण जो टोकन उपयोग पर ~40% बचाता है।
चैटबॉट और AI-संचालित अनुप्रयोगों के लिए लॉन्च-पूर्व सुरक्षा सत्यापन।
ऑडिट के लिए तैयार रिपोर्ट के साथ विनियमित उद्योगों में AI तैनाती को प्रमाणित करें।
नए AI खतरों को खोजने के लिए पेशेवर-ग्रेड हमला सिमुलेशन।
किनारे के मामलों के व्यवहार को पारदर्शी रूप से खोजने के लिए नियंत्रित वातावरण।
Shannon AI launched publicly on November 8, 2025. After overwhelming success, Shannon Lab LLC was founded to deliver enterprise-grade AI security tooling.
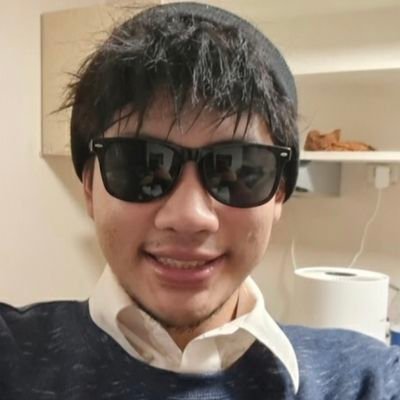
8 years as a Hardware Engineer in North Carolina. Designed Shannon's proprietary GPU inference stack and leads all model training.
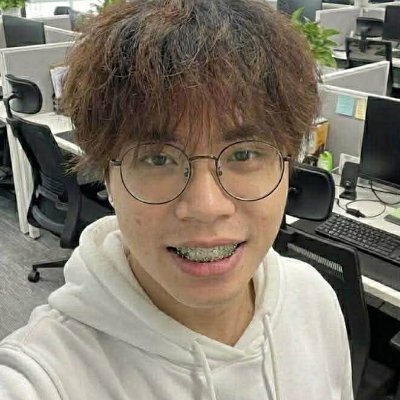
Co-founded Shannon Lab alongside Felix. Leads finance, operations, and strategic growth. Ensures sustainable scaling of infrastructure and enterprise partnerships.
Shannon AI - LLM सुरक्षा के लिए फ्रंटियर रेड टीम लैब। हम प्रतिकूल हमलों का अनुकरण करने के लिए बाधा-रहित LLM का उपयोग करके एक नियंत्रित, सैंडबॉक्स वातावरण प्रदान करते हैं, जो संगठनों को जेलब्रेक, प्रॉम्प्ट इंजेक्शन और नीति बायपास जैसी कमजोरियों को उजागर करने में मदद करता है, इससे पहले कि उनका फायदा उठाया जा सके।
Shannon को विशेष रूप से रेड-टीमिंग के लिए बनाया गया है, जिसमें हमारा proprietary डार्कइवल बेंचमार्क 96% शोषण कवरेज प्राप्त करता है। फ़िल्टर किए गए मॉडल के विपरीत, हमारा बाधा-रहित दृष्टिकोण उन कमजोरियों का पता लगा सकता है जिन्हें अन्य AI बस पहचान नहीं सकते, जबकि नियंत्रित, ऑडिट योग्य वातावरण बनाए रखते हैं।
हम चार मॉडल भेजते हैं: Shannon V1 Balanced (Mixtral 8x7B) और Shannon V1 Deep (Mixtral 8x22B), दोनों GPT-5 प्रो उत्तर डेटासेट पर प्रशिक्षित; प्लस Shannon V1.5 Balanced (Thinking) और Shannon V1.5 Deep (Thinking), जो चेन-ऑफ-थॉट दृश्यता के लिए डीपसीक आसुत डेटासेट पर GRPO-ट्यून तर्क जोड़ते हैं।
बिल्कुल। सभी परीक्षण पृथक सैंडबॉक्स वातावरण में होते हैं। परिणाम पूरी तरह से लॉग किए गए हैं, ऑडिट योग्य हैं, और NIST AI RMF और ISO/IEC 23894 जैसे अनुपालन ढांचे के लिए मैप किए गए हैं। हम जिम्मेदार सुरक्षा अनुसंधान को सक्षम करते हैं, दुर्भावनापूर्ण गतिविधि को नहीं।
आप हमारे मुफ़्त टियर के साथ तुरंत शुरुआत कर सकते हैं। साइन अप करें, चैट इंटरफ़ेस तक पहुंचें और परीक्षण शुरू करें। एंटरप्राइज़ आवश्यकताओं या कस्टम एकीकरण के लिए, अनुरूप समाधानों के लिए हमारी टीम से संपर्क करें।